什么是 OXR
OXR(Optical Everything Recognition) 是 SoMark 团队发布的文档解析模型,参数量为 13 亿,公开提供源码和模型权重。它将 PDF 和文档图片转换成按阅读顺序排列的 Markdown,也能输出包含版面坐标的 JSON。你可以用 Markdown 建立检索索引,用 JSON 定位原页上的文字、表格和公式。GitHub 仓库
查看中文 README、源码和解析样例。
OXR-1.0 模型
下载 BF16 模型和随附的轻量版面分析权重。
如何使用
- 在线试用。上传 PDF 或图片,对照原页查看 Markdown 和版面框。打开在线 Demo
- Free API。通过 HTTP API、CLI 或 SDK 提交文件。查看接入指南
- 自部署。在自己的 NVIDIA GPU 服务器上运行模型,通过本地 Web Demo、HTTP API 或 SoMark CLI 提交文件。查看自部署步骤
能解析哪些内容
OXR 定义了 13 类版面元素,覆盖标题、正文、页眉、页脚、脚注、图表说明、图片、表格、数学公式、化学方程式、化学结构式、代码块和印章。默认输出会过滤页眉和页脚。完整元素和格式表OXR Free API
OXR Free API 提供开源 OXR 模型的免费在线服务。你可以直接上传 PDF 或图片,无需注册或申请 API 密钥。接入信息
接口列表
同步解析在同一次请求中返回结果。异步解析先返回task_id,再通过查询接口获取进度和结果。
使用 CLI 或 SDK
使用 SoMark CLI 或 SDK 时,将 Base URL 设为上表地址。CLI 的--api-key 可填 dummy。
自部署
在自己的服务器上部署 OXR 后,可以通过本地 Web Demo、HTTP API 或 SoMark CLI 提交文档。准备自部署环境
在 Linux 主机上准备支持 BF16 的 NVIDIA GPU、兼容 CUDA 13.0 的驱动,以及支持--gpus all 的 Docker 环境。官方建议单卡 24 GB 显存用于低并发试用,长文档或较高并发建议单卡 48 GB 或以上。使用 Python 3.12 环境安装模型下载工具。部署条件与常见问题
下载模型并启动服务
克隆 OXR 仓库并下载完整的OXR-1.0 模型目录。这个目录同时包含识别模型和 layout_analysis/ 中的版面分析权重。
http://localhost:8000/demo 体验解析,或打开 http://localhost:8000/docs 查看接口。示例将端口绑定到部署主机的回环地址。
调用自部署的解析接口
将document.pdf 放在终端当前目录,用以下命令向本机服务提交同步解析请求。两个 output_formats 字段分别请求 Markdown 和 JSON。
code 为 0 时,从 data.result.outputs.markdown 读取 Markdown,从 data.result.outputs.json 读取带版面信息的 JSON。
如果希望把输出直接保存到文件,可使用 SoMark CLI。把 Base URL 指向本机服务的 /v1,并用 md,json 选择输出格式。
bbox 坐标定位原页区域。接入应用时,先查看 OXR 支持的接口和参数。SoMark与OXR接入差异
从源码启动
如果你要分别部署识别和版面模型,按仓库说明先启动两个模型服务,再将各自地址填入文档解析服务的配置文件。官方源码部署步骤公开评测
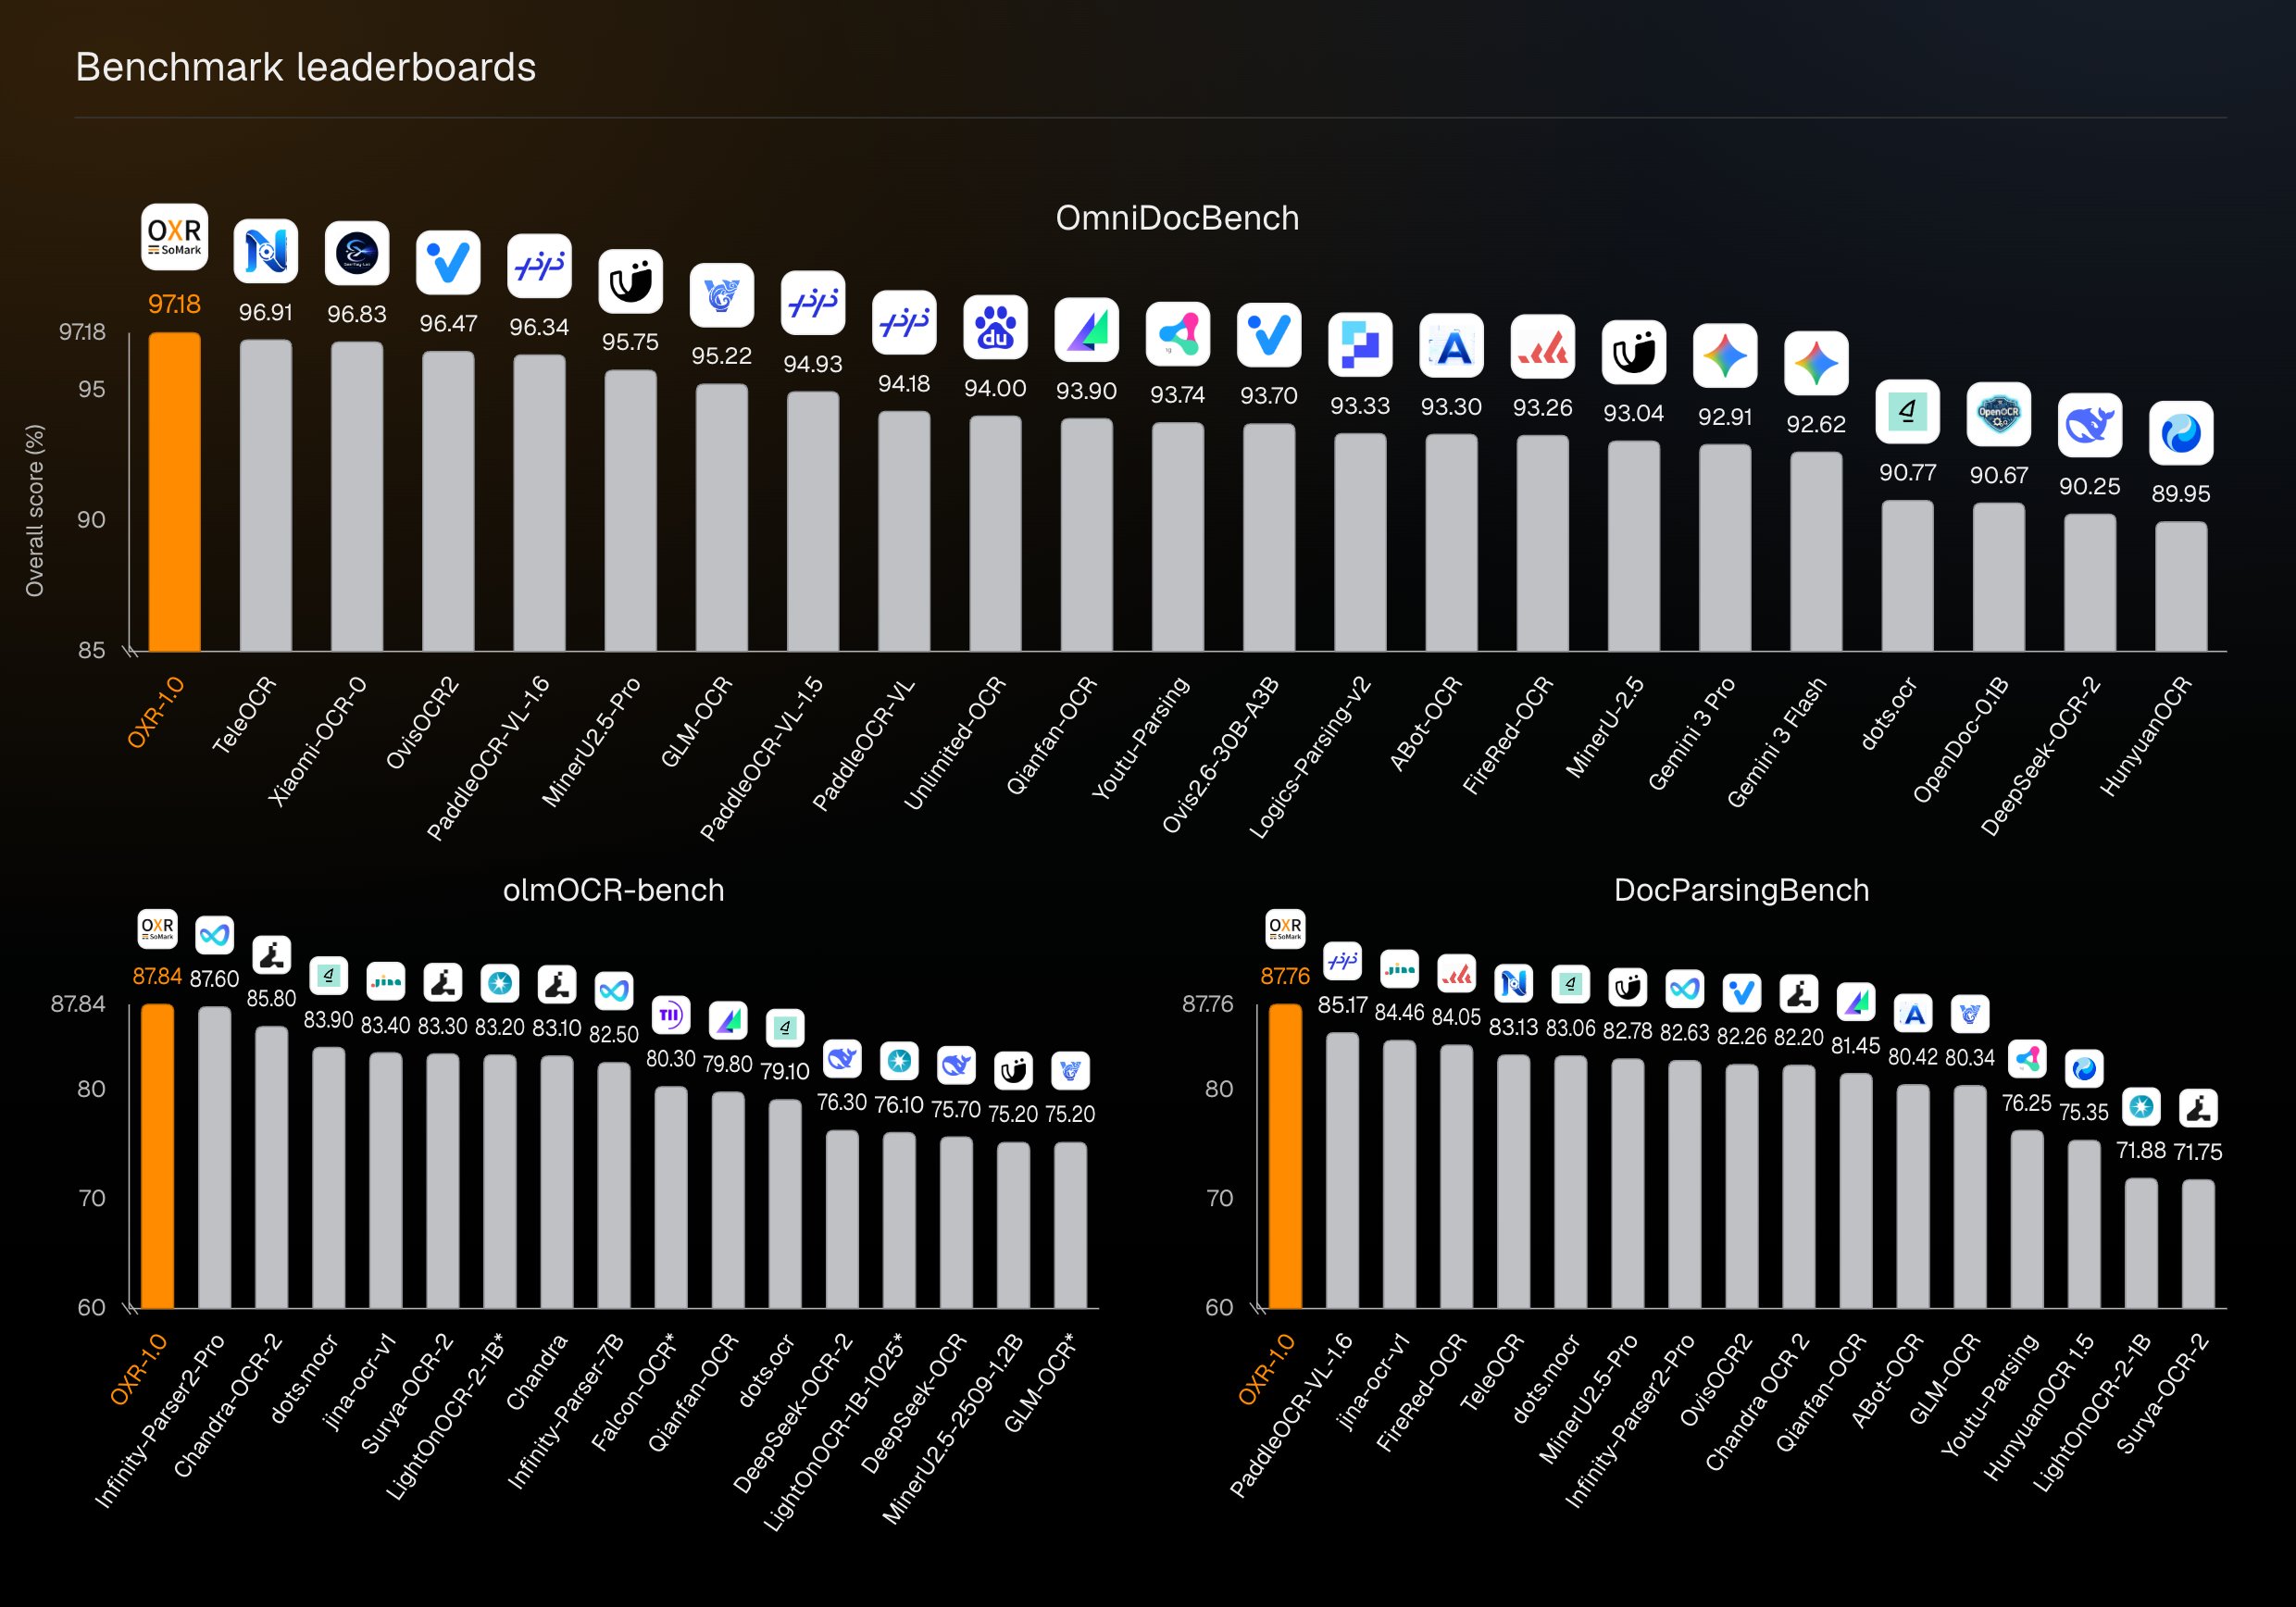
OmniDocBench、olmOCR-bench 和 DocParsingBench 的总体得分分别为 97.18、87.84 和 87.76,在各自列出的模型中排名第一。官网榜单
项目还在一张 96 GB NVIDIA RTX PRO 6000 Blackwell 上测试了固定的 100 页 OmniDocBench 样本。OXR 的端到端吞吐量约为 0.99 页/秒,包含版面分析、内容识别和阅读顺序处理。评测条件与完整结果
OXR 采用基于 Apache 2.0 的 OXR 许可证,并附加商业授权及署名条款。许可证全文